
爬取北京的二手房数据
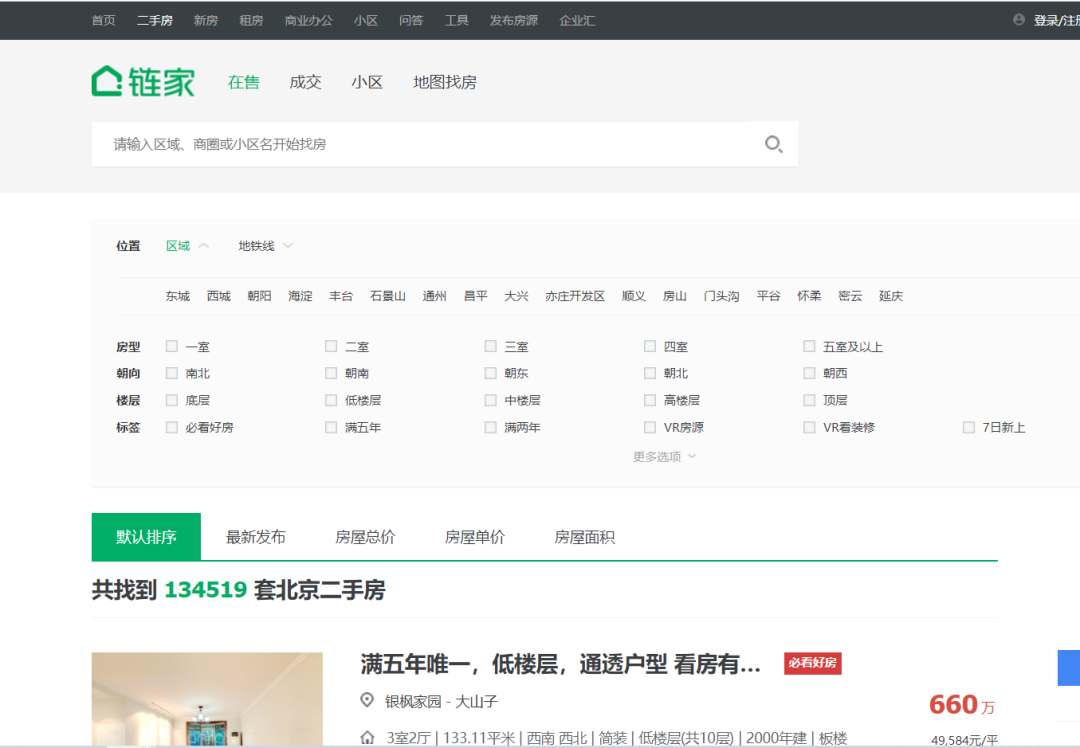
网址示图
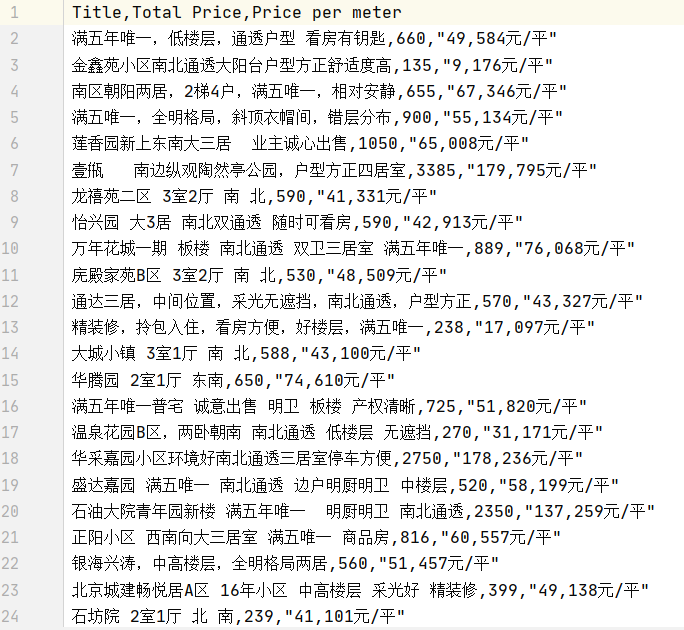
结果示图:
代码如下:
import requestsfrom bs4 import BeautifulSoupimport csvheaders = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'}# 使用某一城市的链家二手房URL作为示例url = 'https://bj.lianjia.com/ershoufang/' # 请替换为实际的URLresponse = requests.get(url, headers=headers)soup = BeautifulSoup(response.content, 'html.parser')# 提取数据houses = []# 根据实际网页结构提取信息,这里的选择器是示例,请根据实际HTML结构进行调整for item in soup.select('.info'):title = item.select_one('.title a').text.strip()price = item.select_one('.priceInfo .totalPrice span').text.strip()per_meter = item.select_one('.priceInfo .unitPrice span').text.strip()houses.append([title, price, per_meter])# 保存到CSVwith open('lianjia_houses.csv', 'w', newline='', encoding='utf-8') as file:writer = csv.writer(file)writer.writerow(['Title', 'Total Price', 'Price per meter'])writer.writerows(houses)
The End
发布于:2023-09-13,除非注明,否则均为原创文章,转载请注明出处。
还没有评论,来说两句吧...